이번 명절에 주어진 약간의 남는시간을 활용해서, 최근 몇달간 계속 미뤄두고 있었던 xpenology -> truenas 마이그레이션을 진행했다.
아직 파일 정리 같은건 안끝났지만, 대부분의 파일을 복사 완료했고 컨테이너도 당장 필요한 것들은 truenas쪽에서 작동되게 작업이 끝난 상태.
도합 2테라바이트 정도되는 일부분의 파일들을 서버간에 이동을 시켰는데,
이 2테라의 대부분은 영상 사진 음악 같은 하나하나가 큼직한 파일들이라기보다는 잡다한 텍스트파일 설정파일들이 대부분이었다.
이 잡다한 파일들을 cmd+c cmd+v로 옮기게 되면 랜덤 읽기쓰기가 많아져서 속도가 엄청나게 느려졌던 것으로 기억을 하는데, truenas 환경에서 Rsync Tasks를 사용하니 시간을 대폭 절약하고 엄청 빠르고 편하게 파일들을 옮길수 있었다.
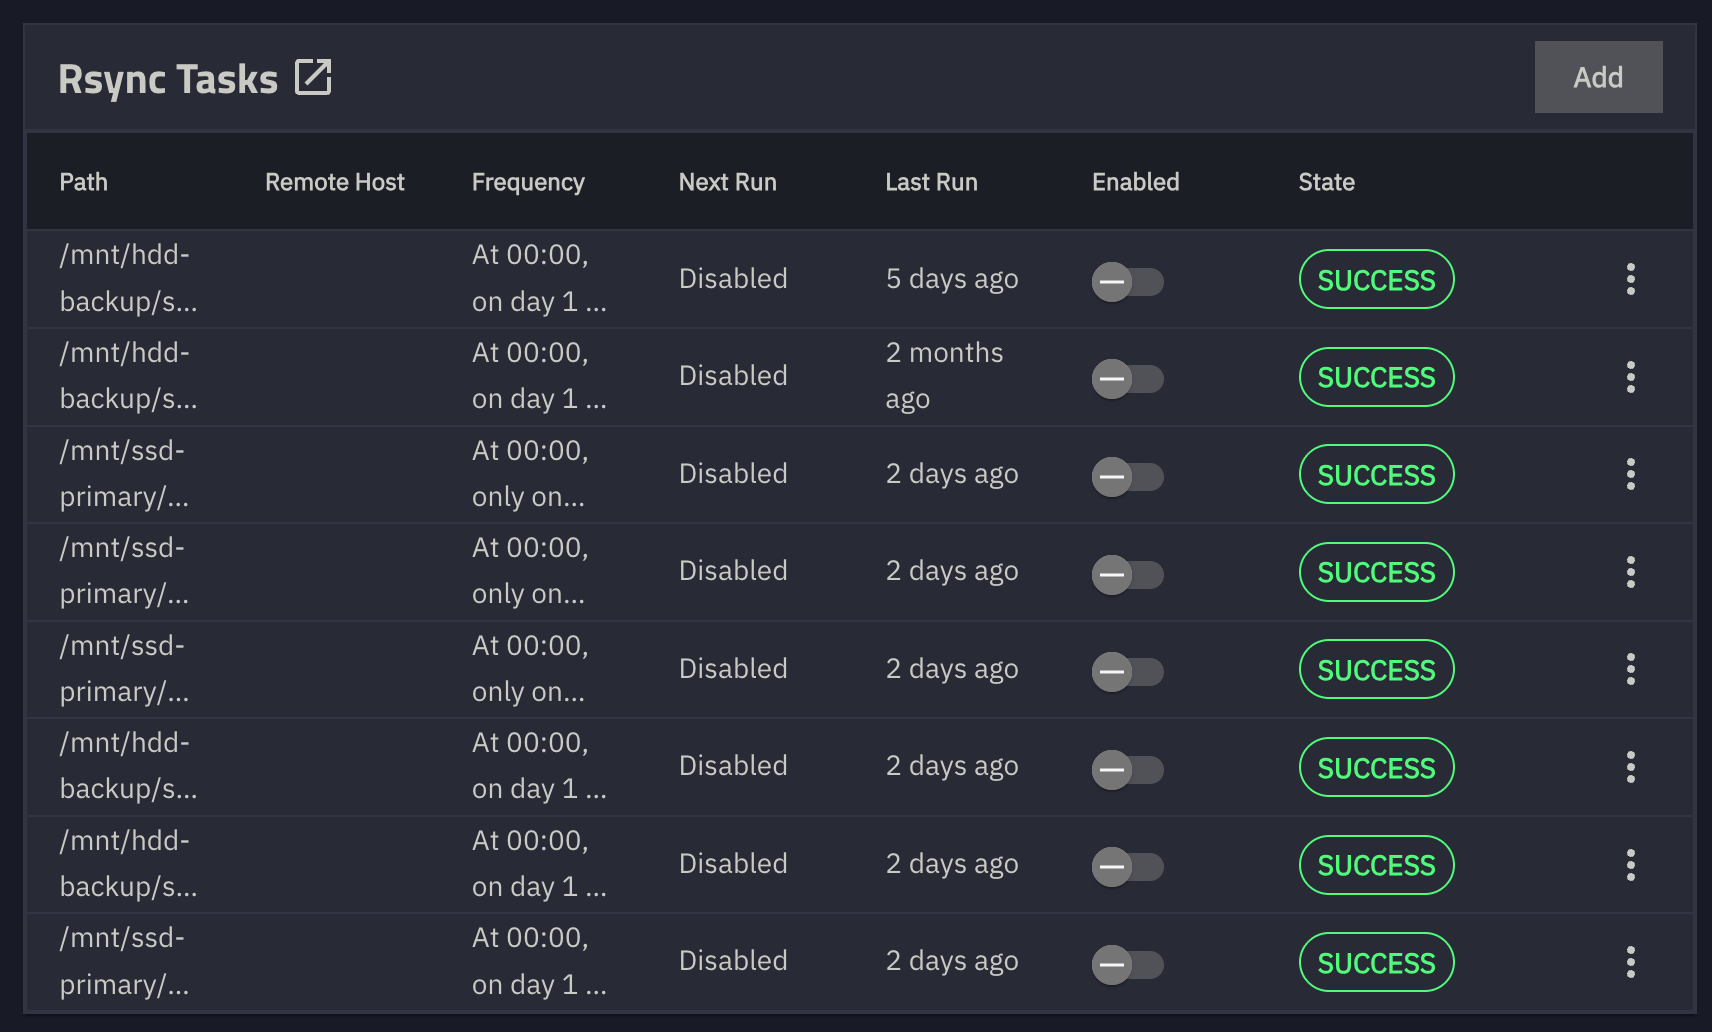
여기서 드는 궁금증은 truenas에서의 rsync는 무엇이길래 일반 cmd c/v랑 무엇이 다르길래 속도가 빠르며 증분 동기화가 가능한지? 이고 이에 대해 조사해보고 공유해보고자 한다.
rsync란
remote sync의 약자(꽤나직관적이다)
얘가 전송을 하는 주된 내부로직은 동기화를 할때 파일 단위로 최신본 비교를 하는게 아니라 블록 단위로 하는것에 있다고 한다.
그렇다면 블록이란 무엇인가?
filesystem에서의 블록이라는 단위.
일반적으로 블록이라고 하면 파일시스템에서 4KB단위로 읽기쓰기 하는 블록이 생각날것이다.
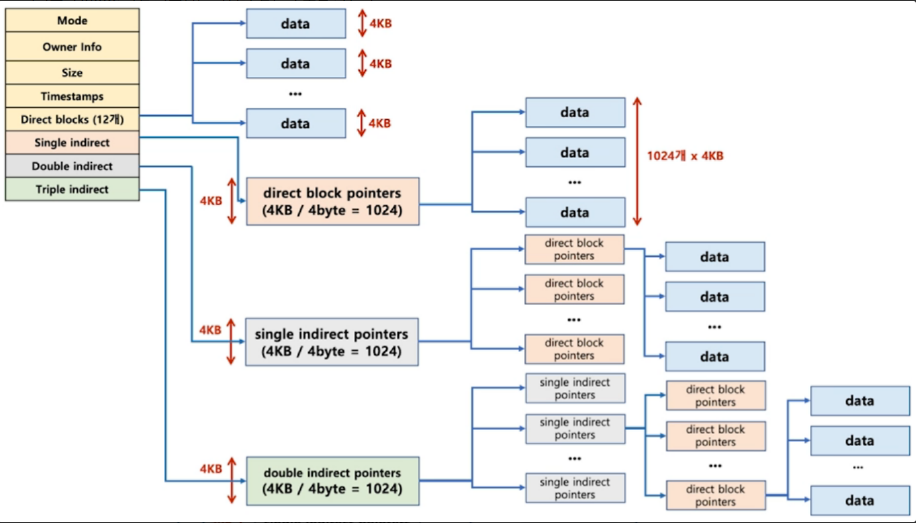
이 블록은 4KB라는 고정된 크기를 가지고 하드디스크라는 물리계층의 디스크 섹터, 혹은 메모리 페이지 크기와 연관을 가지게 되는데, 일반적인 로컬 하드디스크간의 파일 복사 및 이동에서는 이 4KB라는 단위의 배수 만큼 공간을 할당하고 이동시키고 하게 된다.
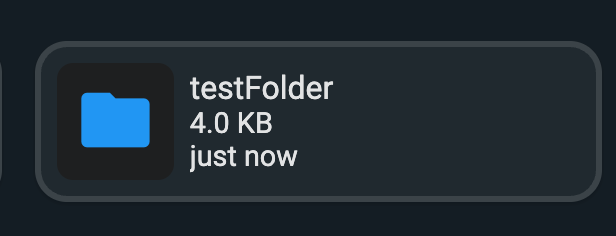
그 일례로서 홈서버에서 사용중인 filebrowser quantum 에서 빈 폴더를 만들고 그 폴더의 크기를 보면, 리눅스 파일시스템의 최소 할당 단위, 즉 블록의 크기인 4KB를 관찰할 수 있다.
rsync에서의 블록
그러나 놀랍게도 rsync는 이 4KB크기의 블록을 사용하지 않고 자체적으로 논리적인 블록이라는 단위를 만들어서 사용하는데, 이 블록은 마치 알고리즘에서 sqrt_decomposition 하듯이 루트질을 해서 파일크기의 sqrt개 만큼의 블록을 가지고 전송을 시도한다고 한다.
굳이 4KB라는 단위가 아니어도 하나의 고정된 크기를 가지고 통신을 하는게 당연히 일반적일텐데, 이런 선택을 왜 했는가를 알아보려면 증분 복제에 대해 이해해야 한다.
증분 복제
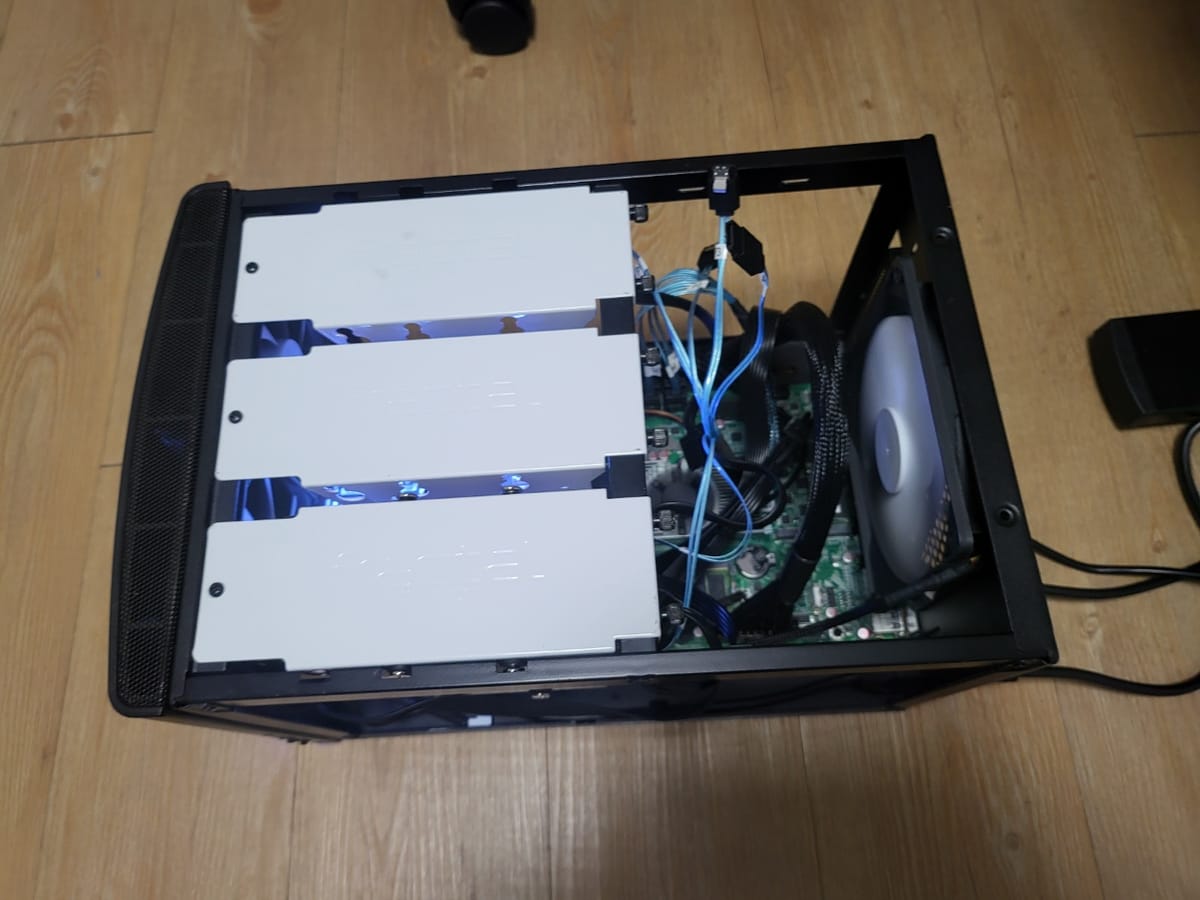
지금 내 홈서버는
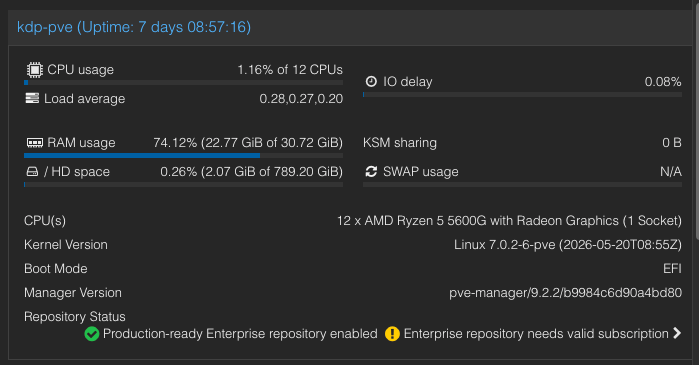
r5 5600g 기반의 조립컴 서버와n100 기반의 미니pc 두개를 동시에 굴리고 있다.
"동시에" 굴리고 있는것이 중요하고, 어느 한쪽에 있는 파일을 지속적으로 동기화해주어야 할 필요가 있으며, 이를 지금은 미니pc를 메인으로, 조립컴을 서브로 사용하고 있다. ( 미니pc에는 xpenology가 설치되어있다 )
미니 pc에 있는 2테라바이트 정도의 데이터를 매주 복제하면서 양쪽을 동기화하는것은 매우 장비 수명에 안좋은 일이므로, 지난주의 파일로부터 변경분 만을 확인하고 갱신하게 되는데, 이를 증분 복제라고 한다.
이때 어떤 부분이 변경되었는지 추적하고 수정하기위해서 부분의 단위가 필요한데, 이러한 단위가
- 파일 단위일때도 있고,
- 4KB나 64KB같은 시스템 단위로 하는 경우도 있으며,
- 메타데이터를 보고 하는 경우도 있다.
왜 하필 루트질을 하는가
어떤 파일의 변경을 추적하고 갱신하겠다는건 다시말해서 그 부분에서 불일치가 발견되면 해당 부분을 하나의 단위로 보고 통째로 다시 확인하고 갱신한다는 뜻이다.
이 단위가 정상적인지를 검증하기 위해서 보통은 해싱을 하게 될 텐데, 해싱 역시 연산이므로 해싱을 최소화하고싶다는 생각을 당연히 할 수 있다.
하지만 그와 동시에 해싱을 통해 비교해서 일치하지 않은 경우 재전송하는 비용을 줄이고 싶으므로, sqrt decomposition과 비슷하게 그냥 산술기하평균 쓰면 파일크기의 루트 단위로 버킷을 두는게 가장 최적임을 알 수 있다.
근데 속도는 왜 빠름?
이를 통해 rsync의 증분 복제 방법에 대해서는 설명할 수 있었지만, xpenology에서 truenas로 파일을 복사해올때의 빠른 속도는 설명할 수 없다. 오히려 작은 파일도 루트개의 블록으로 쪼개면 손해를 보면 봤지 이득을 보지는 않기 때문이다.
raid1로 구성된 드라이브
읽는쪽(Xpenology)과 쓰는쪽(Truenas) 양쪽 모두 raid1로 드라이브 한 쌍을 묶어서 사용하고 있었다.
raid1은 두개의 드라이브에 완벽히 똑같은 데이터를 복제해서 들고 있으므로, 여러개의 작은 파일 읽기 요청이 동시다발적으로 밀려들어올때 두 드라이브에 요청을 분산해서 읽기속도를 최대 두배까지 올릴 수 있다는 특징이 있다. 이것을 통해 읽는쪽에서의 속도 문제를 어느정도 해소할 수 있다.
ZFS
트루나스에서 사용하는 ZFS 파일시스템이 연속된 쓰기를 깔끔하게 처리할수 있었던게 아마 속도에서 가장 큰 영향을 주지 않았나 싶다.
트랜잭션 그룹(TXG)를 통해, 잡다하게 들어오는 작은 파일들의 쓰기 요청을 램에 임시 적재해두었다가 한번에 묶어서 몇백 메가바이트씩 seq Write로 디스크에 기록하기 때문에 쓰기면에서도 작은파일을 여러개 쓸때 병목이 적다고 한다.
자세한 원리에 대해서는 아래 글을 참조하면 좋을 것 같다.
 Jim Salter
결론
실제로 ZFS는 아마 다른 파일시스템 대비 순수 i/o 성능은 떨어지는 것으로 알고 있는데, 이러한 결과가 나온게 좀 신기해서 정리를 시도해봤다.
여전히 내 안에서 딱 떨어지는 확답은 안 내려진거 같은데, 대충 어느정도 납득할만한 답은 나온듯. 이 글은 추후 지식을 더 얻게되면 계속 보충할거같다.
일반적으로 그냥 사용하던 복사 방법 대비 서버-서버간 파일 전송 방법을 사용하는것이니 아무래도 자잘자잘한 최적화가 다양한 곳에서 많이 되어있어 유의미한 체감이 있었던 것 같다.
트루나스로 시스템을 옮기는게 괜히 공수만 많이 들고 어드민페이지 더 복잡하게 생겼고 아무래도 xpenology 대비
아 이거 옮기기로 결심은 했는데 진짜 옮겨야하나...
긴가민가 하던 고민을 싹 걷어주는 퍼포먼스를 볼 수 있었던거같아서 만족스럽다. xpenology는 아무래도 소비자향이라는 느낌이 있어서 이런 빠릿함이 별로 없었던것 같단 말이지...
나머지 파일들 다 옮기고 헤놀로지는 더이상 안 쓸 계획인데, 이번 명절에 밀린 일 하나 처리할 수 있어서 체증이 내려가는 기분이다.